SRE de 0 a 100
Guía completa
SRE de 0 a 100
Cómo lograr que un sistema haga lo que sus usuarios necesitan, siempre
Presentación de Bruno Villarreal, basada en Site Reliability Engineering, 2.ª ed., editado por B. Beyer, C. Jones, C. Leng, D. Huska, J. Petoff y N. R. Murphy (O’Reilly, 2026; CC BY-NC-ND 4.0)
El mapa: seis capas de salud en producción
El recorrido sigue el modelo que propone el capítulo 1, de los cimientos hacia la meta
Capa 1
Fundamentos sociotécnicos
¿Confiamos unos en otros?
Capa 2
Conciencia situacional
¿Sabemos qué está pasando?
Capa 3
Preparación continua
¿Estamos listos para cuando falle?
Capa 4
Diseño de infraestructura
¿Entregamos y sostenemos el software con orden?
Capa 5
Productos resilientes
¿Una falla se queda pequeña?
Capa 6
Confiabilidad emergente
¿Sale confiable sin esfuerzo extra?
Se avanza en paralelo: no hace falta terminar una capa para empezar la siguiente.
Basado en cap. 1, “Introducción: modelar lo que hacemos y por qué”, de Christof Leng, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Funciona en pruebas, falla en producción
Ejemplo ilustrativo: un CRM con todas sus funciones que no es un servicio confiable
Con muchos usuarios a la vez, el sistema se vuelve lento
Una actualización interrumpe el servicio
La base de datos llega a su límite de conexiones
La página carga, pero no deja guardar
Nadie recibe una alerta hasta que un cliente avisa
No es un servicio confiable
Aunque la página siga cargando
IncorrectoQué es confiable
Software que cumple su función sin fallar, con alta probabilidad; cuánta probabilidad se exige depende del uso.
Basado en cap. 1, “Introducción: modelar lo que hacemos y por qué”, de Christof Leng, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Tratar la operación como un problema de software
Eso es SRE, y trae tres ventajas
Comprensión medible
Objetivos de servicio, observabilidad, análisis desde cero y postmortems sin culpas.
Automatización
Más eficiencia y consistencia, y presión por simplificar. El ideal: automatizar tu propio trabajo para pasar a otro.
Integración con desarrollo
SRE habla el idioma de quien programa y devuelve a desarrollo lo que aprende en producción.
Tope de trabajo operativo en SRE de Google. Es un límite, no una meta: en la práctica se busca mucho menos.
Todo SRE debe poder escribir código, aunque sea la configuración del monitoreo.
Basado en cap. 1, “Introducción: modelar lo que hacemos y por qué”, de Christof Leng, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Site, Reliability, Engineering
Las tres palabras del nombre: el porqué, el qué y el cómo. La función nació en Google en 2003
Site
El porqué: ligar el trabajo con el negocio y con las personas que usan el producto.
Reliability
El qué: poner el foco en que el servicio se comporte como se espera.
Engineering
El cómo: con mentalidad de ingeniería de software, repetible y que escale.
Tres preguntas para saber si algo es trabajo SRE
¿Se alinea con las metas del negocio?
¿Mejora la confiabilidad?
¿Usa un enfoque de ingeniería?
Basado en cap. 1, “Introducción: modelar lo que hacemos y por qué”, de Christof Leng, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Una voz dedicada a la confiabilidad
Es una función esencial: de nada sirve un auto de lujo que no arranca
Difícil a medio tiempo
La confiabilidad rinde a largo plazo y pierde frente a los lanzamientos.
Profunda y amplia
Más práctica diagnosticando y diseñando, y visión de muchos sistemas.
Habilita, no vigila
Acompaña a desarrollo en vez de ser el guardián que dice que no.
Sin equipo SRE también puedes aplicar
Objetivos de servicio (SLO)
Gestión de incidentes
Postmortems sin culpa
Gestión de riesgo
Matiz del cap. 6: una sola persona SRE aislada no es sostenible, porque se vuelve un punto único de falla.
Basado en cap. 1, “Introducción: modelar lo que hacemos y por qué”, de Christof Leng, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Disponible no es lo mismo que confiable
Ejemplo ilustrativo: un CRM en cinco situaciones
| Situación del CRM | ¿Infra disponible? | ¿Servicio confiable? |
|---|---|---|
| Carga y guarda bien | Sí | Sí |
| Carga, pero guardar da error | Sí | No |
| Carga, pero tarda más de lo tolerable | Sí | No |
| Muestra importes equivocados | Sí | No |
| Funciona, pero pierde registros | Sí | No |
Fallas grises
Degradación parcial: picos de lentitud o servicio a medias. No es «sirve» o «no sirve».
Falla «exitosa»
En Google Maps el monitoreo decía que todo iba bien, pero la búsqueda devolvía resultados vacíos.
También: cap. 9, «Observabilidad y monitoreo» (Alex Bramley y otros).
Basado en cap. 3, “Tendencias en producción”, de Derek Remund, Garrett Plasky y Roman Seibel, entre otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Por qué invertir en confiabilidad
Con SRE los costos crecen más despacio que el servicio; una caída cuesta mucho más que su duración
Horas de ingeniería por cada hora de caída (ejemplo del libro)
| Tarea | Horas |
|---|---|
| Atender la caída (operaciones) | 5–10 |
| Revisión posterior y acciones | 10–20 |
| Comunicación interna | 20–50 |
| Remediar las acciones | 100 |
| Comunicación con clientes | 100 |
de costo directo: ~400 personas dos días sin sistema por un respaldo fallido (800 días-persona)
horas de gestión por cada hora de caída
Perseguir 100 % de disponibilidad casi siempre es el objetivo equivocado: frena funciones y encarece.
Los cambios en producción son la mayor causa de caídas en Google.
Basado en cap. 2, “El valor de la confiabilidad”, de Ben McCormack y otros, con Garrett Holthaus — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Un mismo trabajo, muchos nombres
SRE, DevOps, plataformas y «tú lo construyes, tú lo operas» conviven; los principios técnicos no dependen del organigrama
Quien construye, opera
Es el modelo por defecto en muchas empresas y suele ser lo mejor al inicio de un servicio.
Equipo SRE aparte
Conviene cuando el servicio crece y la confiabilidad necesita una voz que no cambie con cada prioridad de producto.
Plataforma interna
Las prácticas vienen incluidas: la confiabilidad por defecto en lugar de depender de que cada equipo la recuerde.
Caso Spotify
Sin SRE central: cada equipo opera lo suyo sobre una plataforma estandarizada, y una persona de guardia rotativa coordina los incidentes entre equipos.
También: prólogo (Benjamin Treynor Sloss), prefacio (los editores) y caso Spotify del cap. 6 (Laura Morgan y Oskar Arvidsson).
Basado en cap. 6, “Estructuras organizacionales para SRE”, de Brian Kudzia, Christof Leng, Derek Remund y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
De la pirámide de Dickerson al modelo actual
En 2013 Mikey Dickerson ordenó las necesidades de un servicio; el libro la juzga insuficiente
Los siete peldaños de 2013, de la base a la cima
- 1Monitoreo
- 2Respuesta a incidentes
- 3Postmortem y causa raíz
- 4Pruebas y procedimientos de lanzamiento
- 5Planificación de capacidad
- 6Desarrollo
- 7Producto
Qué le faltaba
Reactiva
Pesa más lo que se hace después de que algo falla.
IncorrectoMezcla temas
La integridad de los datos queda dentro de «desarrollo».
IncorrectoSin cultura
No la menciona.
IncorrectoHoy
Seis capas, con la cultura en la base y el foco en diseñar y prepararse, no en apagar crisis.
CorrectoBasado en cap. 1, “Introducción: modelar lo que hacemos y por qué”, de Christof Leng, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
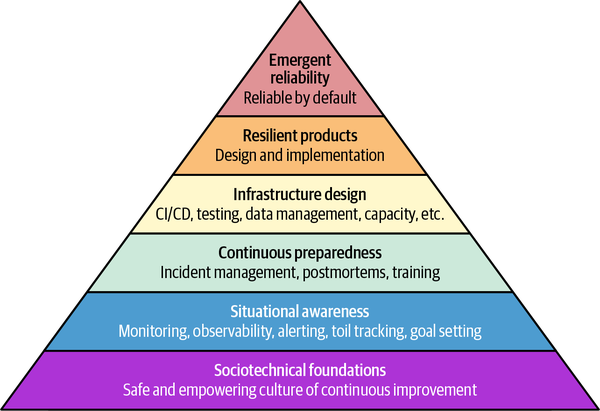
Las seis capas, en una imagen
- 6
Confiabilidad emergente. La meta: que la plataforma impida, o haga visibles, clases enteras de errores y el producto salga confiable de fábrica.
- 5
Productos resilientes. Que una falla no tumbe todo: partes independientes, degradación elegante y pocas dependencias.
- 4
Diseño de infraestructura. Cómo se entrega y se sostiene el software: lanzamientos graduales, configuración versionada, datos recuperables.
- 3
Preparación continua. Estar listos para la falla: detectar pronto, responder con roles claros y aprender para no repetirla.
- 2
Conciencia situacional. Saber qué ocurre: señales del sistema, objetivos medibles, avisos y control del trabajo repetitivo.
- 1
Fundamentos sociotécnicos. Personas que confían entre sí, se equivocan sin miedo y mejoran un poco cada día.
Basado en cap. 1, “Introducción: modelar lo que hacemos y por qué”, de Christof Leng, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Parte II · capítulos 4 a 7
Capa 1
Fundamentos sociotécnicos
Las herramientas y la automatización funcionan porque hay personas que las construyen, las operan y se organizan a su alrededor. Esta capa trata de cultura, personas, equipos y colaboración.
- 1. Fundamentos sociotécnicos
- 2. Conciencia situacional
- 3. Preparación continua
- 4. Diseño de infraestructura
- 5. Productos resilientes
- 6. Confiabilidad emergente
Basado en la introducción de la Parte II, de Beyer, Jones, Leng, Huska, Petoff y Murphy (eds.) — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 1
Cultura de confiabilidad
La base de todo lo demás: dos pilares, siete elementos y lo que dicen los datos
Dos pilares
Foco en el usuario
Equilibrar confiabilidad y velocidad, y medir lo que el usuario vive.
La confiabilidad como valor
Se reconoce desde ingeniería hasta dirección, y SRE participa en las decisiones.
Siete elementos que los sostienen
- Datos como guía
- Responsabilidad compartida
- Aprendizaje continuo
- Ausencia de culpa
- Seguridad psicológica
- Confianza
- Empoderamiento
Equipos con prácticas modernas, SRE incluido (DORA 2021)
1.4×
más probable un mejor desempeño de entrega y operación
1.8×
más probable mejores resultados de negocio
Cultura generativa (Westrum)
Westrum clasifica las culturas según cómo circula la información: orientadas al poder, a las reglas o al desempeño. La última, llamada generativa, es la que corresponde a una cultura de confiabilidad.
Basado en cap. 4, “El contexto cultural de SRE”, de Ayelet Sachto y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 1
Sin culpa, con responsabilidad
Aprender del error sin señalar a nadie, y sin dejar de rendir cuentas
Seguridad psicológica
Poder hablar sin miedo a castigos ni humillaciones; sin esto falla la respuesta a incidentes.
Conciencia de la culpa
Al revisar una falla, preguntar por qué la decisión tenía sentido entonces, no quién se equivocó.
Responsabilidad restaurativa
Sin culpa no significa sin responsabilidad: quienes decidieron ayudan a diseñar y entregar la mejora.
Sin héroes
El heroísmo individual oculta fallas del sistema y agota a las personas; compartir el conocimiento lo evita.
Cultura justa: distingue la conducta
4Delito
Aun así hay postmortem: mínimo privilegio y auditoría
3Imprudencia
2Conducta de riesgo
1Error honesto
También: cap. 11, «Aprender de los incidentes» (James Brookbank y otros), para la responsabilidad restaurativa.
Basado en cap. 4, “El contexto cultural de SRE”, de Ayelet Sachto y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 1
Personas, equipos y colaboración
Quién hace el trabajo, con qué tope de carga y cómo se coordina
Trabajo operativo: tope
50 %
Guardia (atender alertas): tope
25 %
Perfil en forma de T
Amplitud en muchos sistemas y profundidad en uno; la amplitud predice mejor el éxito que una sola especialidad.
Nunca un SRE solo
Una persona sola es punto único de falla; con poca gente, mejor llevar la mentalidad SRE al equipo de desarrollo.
Alianzas por resultados
Desde 2025 Google organiza el trabajo en resultados concretos, no en niveles de apoyo ni en quién atiende las alertas.
Reunión de producción semanal
Agenda fija: caídas y alertas, postmortems, metas de servicio (SLO), tickets y cambios próximos.
También: cap. 5 (Igor Oks y otros), cap. 7 (Brian Kudzia y otros) y apéndice D, ejemplo de minuta de reunión de producción.
Basado en cap. 6, “Estructuras organizacionales para SRE”, de Brian Kudzia y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Parte III · capítulos 8 y 9
Capa 2
Conciencia situacional
Saber en todo momento cómo está el servicio para quien lo usa: objetivos medibles, observabilidad y alertas que sirvan.
- 1. Fundamentos sociotécnicos
- 2. Conciencia situacional
- 3. Preparación continua
- 4. Diseño de infraestructura
- 5. Productos resilientes
- 6. Confiabilidad emergente
Basado en la introducción de la Parte III, de los editores del libro — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 2 · SLO
SLI, SLO y SLA
Tres siglas para hablar con precisión de qué tan bien funciona un servicio
La idea en dos líneas (ejemplo de SLO: 99.9 % en 30 días)
SLI = eventos buenos ÷ eventos totales
SLO = SLI + objetivo + ventana
SLI · el indicador
De todo lo que ocurrió y cuenta, qué fracción salió bien.
SLO · la meta interna
Un valor cercano a 100 %, pero menor, que el SLI debe alcanzar durante una ventana de tiempo.
SLA · el contrato
Compromiso con clientes externos que trae penalizaciones. Debajo suele haber SLO internos más exigentes.
Un SLO interno no trae multa: quien lo incumple se compromete a dedicar esfuerzo de ingeniería a corregirlo.
Basado en cap. 8, “Objetivos de nivel de servicio”, de Alex Bramley y otros; véase también el cap. 2 (Ben McCormack y otros) — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 2 · SLO
Qué medir: tipos de SLI y recorridos críticos
El indicador correcto depende de cómo interactúa el usuario con el servicio
| Tipo de interacción | SLI que conviene considerar |
|---|---|
| Petición y respuesta | Disponibilidad, latencia y calidad de la respuesta |
| Procesamiento por lotes | Cobertura, corrección, frescura de los datos y rendimiento (throughput) |
| Almacenamiento | Rendimiento, latencia y durabilidad de los datos |
Recorridos críticos del usuario (CUJ)
Se definen desde el punto de vista de quien usa el servicio. Una sonda sintética debe recorrer el flujo completo, no solo pedir la página inicial.
Para empezar
Elige lo más común e importante, mide el camino feliz y arranca con un SLI de latencia. Un proxy de acceso de Google tenía sus SLO en verde pese a caídas porque su sonda solo probaba un backend estático.
Basado en cap. 8, “Objetivos de nivel de servicio”, de Alex Bramley y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 2 · SLO
Elegir el objetivo: ¿por qué no 100 %?
Cada nueve extra cuesta más y casi nunca lo percibe el usuario
Relajado
Para servicios que toleran fallas
99 %
Lo más habitual
Sobre todo 99.9 %, a veces 99.95 %
99.9 %
Exigente
Solo donde el costo se justifica
99.99 %
Decide un grupo mixto
Negocio, producto, ingeniería y operaciones. No es una decisión solo técnica.
Pocos SLO
Menos de cinco SLO de alto nivel por servicio suelen bastar.
Un arranque razonado
Copiar el desempeño actual evita la discusión, y esa discusión es justo el beneficio.
Basado en cap. 8, “Objetivos de nivel de servicio”, de Alex Bramley y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 2 · SLO
Presupuesto de error
Lo que el SLO te permite fallar sin incumplirlo
Fórmula · SLO de 99.9 % en 30 días
Presupuesto = 100 % − SLO
100 % − 99.9 % = 0.1 %
Equivale a
de caída total permitida en 30 días
43.2 min
Presupuesto consumido (ejemplo)
70 %
Con cuatro nueves (99.99 %) el margen baja a unos 4 minutos con 23 segundos al mes.
Basado en cap. 8, “Objetivos de nivel de servicio”, de Alex Bramley y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 2 · SLO
Política de presupuesto de error
El presupuesto cierra el ciclo: sobra, se arriesga; falta, se estabiliza
Esfuerzo en confiabilidad según el presupuesto (ejemplo ilustrativo)
Presupuesto sano
10–15 %
Presupuesto agotado
≈ 50 %
Zona roja
≈ 90 %
Con presupuesto
Se asume riesgo: despliegues rápidos y pruebas A/B.
Sin presupuesto
Se frenan los cambios y se estabiliza. Un ejemplo del libro congela los despliegues un mes.
Excepciones conscientes
Por ejemplo, la corrección de un bug crítico. La política se acuerda de antemano; no es panacea.
Basado en cap. 8, “Objetivos de nivel de servicio”, de Alex Bramley y otros; véanse también el cap. 4 y el apéndice D — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 2 · SLO
Burn rate y alertas
Burn rate 1× significa que el presupuesto dura exactamente la ventana
14.4×
Alerta rápida
Avisa al pager
Se gastó 2 % del presupuesto en 1 hora.
1×
Alerta lenta
Abre un ticket
Se gastó 10 % del presupuesto en 3 días.
Poco tráfico
Con menos de unas 100 solicitudes por hora, un solo fallo dispara falsas alarmas. Se usa el límite inferior de Wilson.
| Solicitudes | Fallos que alertan |
|---|---|
| 1,000 | 173 |
| 200 | 42 |
| 100 | 24 |
Ejemplo con SLO de 99 %, burn rate de 14.4× y 99 % de confianza. Las cifras de las alertas son para ventana de 30 días.
Basado en cap. 8, “Objetivos de nivel de servicio”, de Alex Bramley y otros; véase también el apéndice G — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 2 · SLO
Latencia: el promedio engaña
El SLO de latencia cuenta qué porcentaje de peticiones queda bajo un umbral
- p50120 ms
- p95400 ms
- p991,200 ms
Cómo se percibe
Hasta unos 100 ms se siente instantáneo; más de 1,000 ms se siente lento.
Ejemplo de SLO
El 99 % de las peticiones en menos de 800 ms. La cola larga importa más que la media.
1. Cohortes
Agrupa cargas parecidas (ej. 10,000 o más casos y poca variación).
2. Línea base
Aprende cómo se comporta cada cohorte con 30 a 60 días de datos.
3. z-score
Alerta si crece la fracción de cargas con z mayor que 2 (ejemplo).
Basado en cap. 8, “Objetivos de nivel de servicio”, de Alex Bramley y otros; véase también el apéndice F — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 2 · SLO
SLO implícitos, por cliente y sus límites
El modelo es útil, pero tiene puntos ciegos que conviene conocer
SLO implícitos
Si el servicio siempre fue muy estable, los usuarios lo dan por prometido (ley de Hyrum). Se evita dejando el nivel explícito y avisando los cambios.
SLO por cliente
En B2B con pocos clientes grandes permiten detectar problemas antes de que ellos los noten. Usa identificadores anonimizados.
Debilidades
Solo ve éxito o fallo, sus nueves no son umbrales humanos y no captura calidad, como una respuesta de IA correcta en forma pero mala.
Ciclo de vida de un SLO: solo los comprometidos activan la política
experimental
Se prueba
Aún se aprende qué medir.
aspirational
Se aspira
Meta futura; no debe alertar.
committed
Comprometido
Activa la política de presupuesto.
deprecated
Se retira
Se deja de usar con aviso.
Basado en cap. 8, “Objetivos de nivel de servicio”, de Alex Bramley y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
De monitoreo a observabilidad
Antes todo dependía de lo que la persona de guardia sabía y de cruzar datos a mano. Hoy se combinan cuatro tipos de señal.
Series de tiempo
Números que cambian con el tiempo, como solicitudes por segundo.
Logs
Eventos anchos y estructurados: un registro con muchos campos por cada cosa que ocurre.
Trazas
El recorrido de una solicitud por todos los componentes que toca.
Profiling continuo
Qué partes del código gastan CPU y memoria, medido todo el tiempo.
La meta: reducir el TTM (tiempo hasta mitigar el daño); el TTD (tiempo hasta detectar) va en segundo lugar
Dashboards listos
Vienen armados con la plataforma
Alertas inteligentes
Avisan lo que de verdad importa
Mitigación automática
Acciones genéricas sin esperar a una persona
Basado en cap. 9, “Observabilidad y monitoreo”, de Alex Bramley y otros, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Una traza muestra dónde se va el tiempo
Una aplicación de solo tres capas puede cruzar hasta una docena de fronteras entre componentes.
Ejemplo didáctico propio: guardar un documento · 1,800 ms en total
Con la traza dejas de adivinar si el problema está en el frontend, el backend o la base de datos.
El cap. 3 (D. Remund, G. Plasky y R. Seibel, con otros) las considera una pieza básica. Los tiempos se anidan, por eso no se suman.
Basado en cap. 9, “Observabilidad y monitoreo”, de Alex Bramley y otros, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Señales doradas: punto de partida
Cuatro preguntas básicas sobre un servicio que atiende solicitudes. Sirven para empezar, no para quedarse ahí.
Latencia
¿Cuánto tarda en responder?
Tráfico
¿Cuánta demanda recibe?
Errores
¿Qué parte de las solicitudes falla?
Saturación
¿Qué tan cerca está de su límite de capacidad?
Lo que añade el libro
Lectura de conjunto
El valor está en interpretar las señales juntas, no cada una por separado.
Del servicio al cliente
La observabilidad pasa de mirar cada servicio a mirar el producto y a quien lo usa.
Basado en cap. 9, “Observabilidad y monitoreo”, de Alex Bramley y otros, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
OpenTelemetry y cardinalidad
Un estándar abierto para recolectar la telemetría, y cuidado con los datos que se multiplican.
Un estándar abierto
- OTLP: el protocolo común
- Collector: recibe y reenvía los datos
- APIs e instrumentación lista para usar
Cardinalidad
Cuántos valores distintos puede tener un campo, como el identificador de cada usuario. Las métricas aguantan poca; los logs aguantan mucha, pero son lentos y caros. Más métricas no es mejor.
Una decisión a 10 años
10 años
Así describe el libro elegir producto de observabilidad. Waze proyectó más de un año para migrar a OpenTelemetry.
Abierto, extensible, correlacionable, universal y débilmente acoplado: los cinco principios de OpenTelemetry.
Basado en cap. 9, “Observabilidad y monitoreo”, de Alex Bramley y otros, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Monitoreo centrado en el cliente
Un servidor puede verse sano mientras la persona no logra terminar lo que fue a hacer.
YouTube: subir videos
Las métricas del servidor mostraban alta disponibilidad. Al medir desde el cliente, la experiencia real era peor.
Google Maps: «falla exitosa»
Las respuestas eran válidas pero vacías. El monitoreo de llamadas no lo veía. Lo usan más de
2,000 millones
de personas activas al mes.
Medir lo que la persona intenta lograr
CUJ
Recorrido crítico del usuario: un objetivo más las tareas para lograrlo.
CUI
Interacciones críticas: los bloques con los que se arma cada recorrido.
Basado en cap. 9, “Observabilidad y monitoreo”, de Alex Bramley y otros, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Alertas inteligentes y composición de SLO
Menos umbrales fijos y más estadística; y un techo de disponibilidad que imponen tus dependencias.
Un umbral fijo hace ruido
Un cliente con 20 solicitudes y 1 error ya marca 5 %. Con poco tráfico, un solo fallo dispara la alarma.
Prueba binomial
Se avisa solo si el límite inferior del intervalo de confianza supera la tasa de error que no se tolera. Con un SLO de 99.9 %, esa tasa es 0.001.
Las alertas horizontales, comunes a muchos servicios, son casi 1 de cada 5 de las que atienden los SRE de Google.
Dependencias en serie (todas deben responder)
80 % × 90 %
= 72 %
En paralelo con hedging (falla solo si fallan ambas)
1 − (0.2 × 0.1)
= 98 %
Supone fallos independientes. Tu SLO no puede prometer más que ese techo.
Basado en cap. 9, “Observabilidad y monitoreo”, de Alex Bramley y otros, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Seguir el toil
Es el trabajo de operar un servicio que se come tiempo sin dejar nada duradero. Para controlarlo, primero hay que medirlo.
Un trabajo es toil cuando reúne estas seis marcas
Manual
Repetitivo
Automatizable
Táctico, de reacción
Sin valor duradero
Crece con el servicio
Cómo medirlo
Suma el tiempo que el equipo dedica a esas tareas o pregúntaselo en una encuesta. Cuenta también las alertas que no piden acción y mejora esa proporción.
Un tope, no una meta
La meta no es llegar a cero, sino mantenerlo en un nivel sostenible, igual que un SLO. Ejemplo: bajar de 50 % a 30 % del tiempo.
Trabajo de ingeniería que exige juicio y deja valor, como una política de seguridad, no cuenta como toil.
Basado en cap. 13, “Automatización y herramientas”, de Alex Chiang y otros; véase también el cap. 1 — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Parte III · capítulos 10 a 12
Capa 3
Preparación continua
Responder bien cuando algo falla, aprender de ello y anticiparse a lo que aún no ha fallado.
- 1. Fundamentos sociotécnicos
- 2. Conciencia situacional
- 3. Preparación continua
- 4. Diseño de infraestructura
- 5. Productos resilientes
- 6. Confiabilidad emergente
Basado en la introducción de la Parte III, de los editores del libro — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Duración, frecuencia y alcance
Tres formas de reducir el daño de un incidente; cada una tiene su propia palanca.
Duración
Cuánto tarda en terminar. Palanca: detectar y mitigar rápido, con guardia entrenada y roles claros.
Frecuencia
Cuántas veces ocurre. Palanca: postmortems que quitan las causas para que no se repita.
Alcance
A cuántos usuarios llega. Palanca: dominios de falla y degradación elegante.
No todo problema es lo mismo (cap. 10)
Cualquiera puede declarar un incidente; un falso positivo no se castiga.
Bug
Un defecto en el software. No todo bug llega a ser un incidente.
Incidente
Ya hay usuarios con mala experiencia, algo importante del servicio está degradado o hay una caída en curso o a punto de ocurrir.
Caída
El servicio se interrumpe. No todo incidente llega a ser una caída.
Basado en cap. 1, “Introducción: modelar lo que hacemos y por qué”, de Christof Leng, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Ciclo de vida del incidente y roles
Seis fases que se repiten y se mezclan: no es una receta en línea recta.
1
Detección
Algo avisa de que el servicio anda mal: una alerta o un reporte.
2
Triage
Cuántos usuarios, si es global o local y qué recorrido falla. Clasificar y escalar rápido.
3
Investigación
Google prefiere varias hipótesis a la vez antes que perseguir una sola causa raíz.
4
Mitigación
Frenar el daño antes de entender el porqué.
5
Resolución
Volver al estado estable; entre «mitigado» y «resuelto» puede haber una espera.
6
Aprendizaje
Guardar participantes, alertas, chats y línea de tiempo.
Tres roles (IMAG)
El comandante asume todos hasta delegarlos; un incidente grande se divide en padre e hijos.
Comandante
Coordina la respuesta y reparte el trabajo.
Operaciones
Dirige el trabajo técnico de mitigación.
Comunicaciones
Mantiene informadas a las partes interesadas.
Basado en cap. 10, “Gestión de incidentes y guardia”, de Dan Dennison y otros, con Garrett Holthaus — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Mitigar primero
Frenar el daño va antes que entender la causa. Ejemplo ilustrativo: un despliegue a las 11:00 sube los errores.
11:00
Se despliega el cambio
11:03
Los errores suben al 12 %
11:04
Salta la alerta
11:07
Se revierte la versión
Sin esperar a entender la causa.
11:10
Todo vuelve a la normalidad
7 minutos de impacto en total.
Caja de mitigaciones genéricas (caps. 10 y 17)
Poder aplicarlas es una propiedad de la arquitectura, no solo de la guardia.
Revertir
Volver a la versión anterior.
Ampliar
Dar más capacidad al servicio.
Reiniciar
Reiniciar lo que se atoró.
Mover tráfico
Sacarlo de la parte dañada.
Degradar
Ofrecer menos para no caerse.
Bloquear
Cortar lo que causa el daño.
Basado en cap. 10, “Gestión de incidentes y guardia”, de Dan Dennison y otros, con Garrett Holthaus — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Guardia sostenible y qué medir
Una rotación que aguanta y una métrica que no engaña.
Una guardia que se puede sostener
≤ 2
Incidentes por turno
Como máximo, de 4 a 6 horas cada uno. Con muy pocos tampoco: el equipo pierde práctica.
Respuesta en 5, 30 o 60 minutos
Se elige según el servicio. Para responder en 3 minutos o menos, al menos dos ingenieros disponibles.
Horas de cobertura
Desde horario de oficina hasta 24 horas, según el riesgo para el negocio.
Por qué el MTTR (tiempo medio de reparación o mitigación) engaña (ejemplo ilustrativo)
Incidente A
5 min
Incidente B
10 min
Incidente C
165 min
Promedio: 60 minutos, una cifra que no describe a ninguno de los tres.
Mejor medir cuántas personas y equipos intervinieron y cuánto cuesta coordinarlos.
Basado en cap. 10, “Gestión de incidentes y guardia”, de Dan Dennison y otros, con Garrett Holthaus — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Postmortem sin culpa, versión actual
Aprender de la caída sin buscar culpables, pero sin dejar de responsabilizarse de la mejora.
Ejemplo ilustrativo (no sale del libro): el incidente de las 11:00.
| Componente | Responde | Ejemplo |
|---|---|---|
| Hechos clave | ¿Qué pasó y quién intervino? | 11:00 despliegue, 11:04 alerta, 11:07 reversión; quién hizo cada cosa. |
| Impacto | ¿A quién afectó y cuánto? | 12 % de operaciones fallidas durante 7 minutos. |
| Causas contribuyentes | ¿Qué se juntó para que ocurriera? | Cambió la gestión de conexiones, el pool se agotó, no se medía su saturación y no había canario. |
| Lecciones y acciones | ¿Qué haremos distinto? | Medir el pool, probar con carga y desplegar en canario; cada acción con dueño. |
Qué cambió en la última década
Líder independiente
Dirige el análisis alguien que no participó en el incidente.
Responsabilidad restaurativa
Quienes decidieron ayudan a diseñar y entregar la mejora.
Cliente al centro
También se analiza el impacto y lo que se le comunicó.
Lo que salió bien
Y los casi-incidentes: dónde tuvimos suerte.
Basado en cap. 11, “Aprender de los incidentes”, de James Brookbank y otros, con Garrett Holthaus — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Más allá de la causa raíz
Una caída casi nunca tiene una sola causa.
Buscar LA causa raíz
Toda cadena de eventos se puede alargar hacia atrás, así que dónde se corta es arbitrario. «Error humano» suele ser solo la respuesta más cómoda.
Ver los factores contribuyentes
El error de una persona es un síntoma: hay que entender por qué su decisión tenía sentido y qué en el sistema la propició (enfoque del cap. 12).
Tres lentes de la ciencia de la seguridad
Queso suizo
Fallas activas y latentes se alinean; también revela dónde tuvimos suerte.
Márgenes de Rasmussen
Las presiones empujan la operación al borde de lo aceptable; ahí ocurre el incidente.
Safety I y Safety II
Safety I evita lo malo; Safety II estudia cómo el trabajo normal sale bien.
Basado en cap. 11, “Aprender de los incidentes”, de James Brookbank y otros, con Garrett Holthaus — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
STPA y CAST
Dos métodos de la teoría de sistemas: uno anticipa incidentes desde el diseño y otro aprende de las que ya ocurrieron.
STPA · hacia adelante
Sobre un diseño, modela quién controla qué y busca acciones inseguras y los escenarios que las provocarían, aunque nada esté roto. Uno acotado cabe en menos de una semana con uno o dos expertos.
CAST · hacia atrás
Tras un incidente, reconstruye la estructura de control y por qué cada decisión tenía sentido, hasta llegar a factores del sistema y no a culpables.
Cifras de dos casos de Google Maps (frente a su postmortem)
Recomendaciones
STPA del proceso de aprobación de datos (Japón, 2019): 56 escenarios causales.
34
STPA
7
Postmortem
Recomendaciones
CAST de las ciudades mal nombradas (2024).
22
CAST
8
Postmortem
Horas de trabajo
El mismo CAST: 5 personas frente a 3, y 7 hallazgos frente a 6.
81 h
CAST
16 h
Postmortem
Basado en cap. 12, “Ingeniería de seguridad para SRE con STPA y CAST”, de Garrett Holthaus y otros, con Theo Klein — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Parte IV · capítulos 13 a 16
Capa 4
Diseño de infraestructura
Construir entornos que aguanten el cambio y ganar confianza antes de llegar a producción.
- 1. Fundamentos sociotécnicos
- 2. Conciencia situacional
- 3. Preparación continua
- 4. Diseño de infraestructura
- 5. Productos resilientes
- 6. Confiabilidad emergente
- Cap. 13Automatización y herramientas
- Cap. 14Pruebas
- Cap. 15Planificación de capacidad
- Cap. 16Gestión de datos
Basado en la introducción de la Parte IV, Diseño de infraestructura, de los editores del libro — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 4
Automatizar con criterio, no por reflejo
Automatizar ahorra tiempo rutinario y en emergencias, da consistencia y deja crecer el servicio sin crecer el equipo al mismo ritmo.
Antes de automatizar, compara
Costo = inicial + continuo × vida útil
Ahorro = tiempo × frecuencia × vida útil
Los costos se subestiman: un resultado positivo no es luz verde.
Las ironías de la automatización
Crea trabajo nuevo: vigilarla y repararla.
Las habilidades de quien opera se oxidan.
Cuando falla, exige gente más capaz.
Alertar
Solo avisa cuando detecta el caso
Sugerir
Propone la acción y una persona decide
Actuar y notificar
Ejecuta y deja claro qué hizo
Reiniciar solo ante una fuga de memoria rara es pragmático; si el reinicio pasa de diario a cada hora, esconde un problema.
Basado en cap. 13, “Automatización y herramientas”, de Alex Chiang y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 4
Cambios seguros: poco a poco, vigilados y reversibles
Los cambios en producción son la mayor categoría de desencadenantes de caídas en Google.
0.1 %
Canario
Un grupo mínimo corre la versión nueva
1 %
Primer salto
Se compara con la versión anterior
10 %
Más despacio
Con más tráfico, más cautela
50 %
Mitad
Sigue la comparación estadística
80 %
Casi todo
Última oportunidad de frenar
100 %
Completo
La versión nueva queda como estándar
Una cosa a la vez
No mezcles un binario nuevo y datos nuevos en el mismo despliegue.
Interruptores
Las banderas de funciones y las paradas de emergencia permiten apagar sin volver a desplegar.
Vigilar el cambio
Si la salud empeora, se pausa o se revierte según un procedimiento ya escrito.
Calendario de ejemplo, no una receta. También: cap. 2 (McCormack y otros) y cap. 17 (Shipitsyn y otros).
Basado en cap. 14, “Pruebas”, de Aman Shaikh y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 4
Probar más allá de lo unitario
La configuración es tan peligrosa como el código, y la resiliencia también se prueba.
Configuración que se puede confiar: VOIS
Versionada
Todo cambio queda en control de versiones.
Observable
Se puede ver qué versión corre ahora.
Independiente
Se cambia sin tocar el código.
Segura
Sus valores por defecto son explícitos y prudentes.
Tres pruebas de configuración
Sintaxis: rápida y útil en emergencias.
Semántica: ¿algo quedó en cero o es 300 veces mayor?
Dinámica: ensayo en seco o entorno aislado.
Inyectar fallas con hipótesis
El flujo X resiste la falla Y, medido con la métrica Z.
Empieza con un componente no crítico y un plan de reversión que cualquiera pueda ejecutar.
Ensayos de desastre (DiRT)
Una semana al año en la que Google simula fallas grandes con sistemas reales.
En uno de esos ejercicios operó una semana desde Dublín.
Basado en cap. 14, “Pruebas”, de Aman Shaikh y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 4
Capacidad: primero decide si hace falta planificarla
Con nube elástica y cargas pequeñas, sobreaprovisionar suele costar menos que afinar hojas de cálculo.
Pico de las sumas, no suma de los picos
Reservar el máximo de cada servicio por separado
Reservar el máximo de la suma, que es cuando de verdad coinciden
Unidades de ejemplo del libro: los servicios no llegan a su máximo a la vez.
Criticidad
Si falta capacidad, se descarta primero lo menos crítico.
Una zona de dos
Si cae una, la otra recibe el doble de carga.
Clientes bien portados
Reintentan con espera creciente y azar, para no empeorar la sobrecarga.
Más servidores de API
Ejemplo ilustrativo: la API se degrada a 250 rps y una campaña traería 500 rps
Misma base saturada
El cuello de botella sigue siendo el mismo
Basado en cap. 15, “Planificación de capacidad”, de Andy Gordon y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 4
Datos: lo que se pierde casi nunca vuelve
Un plan de respaldo vale lo que su última restauración exitosa.
Jerarquía de necesidades de los datos, de lo más básico a lo más fino
1
Integridad
Lo que lees es lo que escribiste
2
Seguridad
Acceso mínimo y registro de accesos excepcionales
3
Disponibilidad
Objetivos de disponibilidad y latencia por flujo
4
Eficiencia
Costo de guardar, una vez cubierto lo anterior
RPO
Qué tan viejos pueden ser los datos al restaurar
RTO
Cuánto puede tardar la restauración
RWO
Hasta qué fecha atrás puedes restaurar
La replicación no es un respaldo
Copia también los borrados y la corrupción.
IncorrectoRegla 3-2-1
Tres copias, en dos tipos de medio, una fuera del sitio.
Objetivos de ejemplo del libro: 24 h y 12 h, o 5 min y 3 min. Cap. 3 (Remund y otros): RTO y RPO ya no son indicadores principales, pero sirven en desastres.
Basado en cap. 16, “Gestión de datos”, de John Tobin y Victoria Wang — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Parte V · capítulos 17 y 18
Capas 5 y 6
Productos resilientes y confiabilidad emergente
- 1. Fundamentos sociotécnicos
- 2. Conciencia situacional
- 3. Preparación continua
- 4. Diseño de infraestructura
- 5. Productos resilientes
- 6. Confiabilidad emergente
Capa 5 · Productos resilientes
El producto aguanta lo inesperado y se recupera sin depender de que alguien entienda antes la causa.
Capa 6 · Confiabilidad emergente
La confiabilidad viene incluida en la plataforma, en lugar de depender del esfuerzo de cada persona.
Basado en la introducción de la Parte V, de los editores del libro — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 5
Confiable frente a resiliente
Nueve principios para que el producto aguante lo inesperado
Confiable
Cumple sus objetivos mientras opera dentro de las condiciones para las que se diseñó.
Resiliente
Detecta fallas activas, incluso imprevistas, y responde con planes preparados de antemano.
1 · Riesgo
Qué puede fallar y cuánto dolería
2 · Cambios
Cambios pequeños, graduales y vigilados
3 · Dependencias
Saber de qué depende cada pieza
4 · Dominios de falla
Que un fallo no llegue a todo
5 · Sobrecarga
Seguir sirviendo cuando llega de más
6 · Entradas
Rechazar datos malos antes de usarlos
7 · Datos
Borrar y recuperar sin perder lo vital
8 · Calificación
Probar con realismo que todo lo anterior funciona
9 · Modo de emergencia
Responder aunque fallen las herramientas
Un principio escrito en un documento se olvida: se cumple con valores por defecto de la plataforma, medición y comprobaciones automáticas.
Basado en cap. 17, “Diseñar para la resiliencia”, de Vitaliy Shipitsyn, con Christof Leng, Garrett Holthaus y Kieran Broadfoot — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 5
Sobrecarga y fallas en cascada
Una falla que satura a las demás piezas se propaga: conviene frenarla en el origen
Capacidad aprovisionada
X
Demanda recibida
10 X
La meta no es atender todo, sino seguir sirviendo cerca de X y rechazar el resto con orden, en lugar de caerse.
El servidor prioriza
Descarta primero lo menos importante e indica si conviene reintentar.
El servidor degrada
Responde con menos calidad; por ejemplo, 80 % de calidad con 20 % del cómputo.
El cliente modera
Espera más entre reintentos, con variación al azar, y reintenta en un solo nivel.
Se aísla la demanda
Cuotas por usuario y presupuesto de reintentos por petición y por servicio.
También: cap. 15, «Planificación de capacidad» (Andy Gordon y otros), sobre criticidad y descarte de carga — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Basado en cap. 17, “Diseñar para la resiliencia”, de Vitaliy Shipitsyn, con Christof Leng, Garrett Holthaus y Kieran Broadfoot — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 5
Dominios de falla y modo de emergencia
Aislar el daño y seguir respondiendo cuando fallan hasta las herramientas
Dominios de falla: cuatro formas de aislar
Geográfico
Regiones y zonas distintas
Funcional
Funciones que no dependen entre sí
De infraestructura
Componentes base separados
Operativo
Por ejemplo, turnos de guardia propios
25 %
Con dos regiones de dos zonas, perder una zona quita como máximo esa parte de la capacidad global.
50 %
Con una sola zona por región y sin separar réplicas, la pérdida podría llegar a esta parte.
Modo de emergencia: cuando falla lo que usas para responder
Normal
Todo disponible
Se responde con las herramientas de siempre.
Emergencia
Falla algo de la respuesta
Se recurre a alternativas con pocas dependencias.
Desastre
El caso más grave
La ruta alterna debe estar ya practicada.
Practica primero lo esencial
Comunicarse, llegar a los sistemas, tener documentación y permisos que no dependan de la plataforma afectada.
Basado en cap. 17, “Diseñar para la resiliencia”, de Vitaliy Shipitsyn, con Christof Leng, Garrett Holthaus y Kieran Broadfoot — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 6
De política a defecto
Lo que se deja a la memoria de cada equipo termina repitiéndose
El lamento de Treynor
En los postmortems casi nunca aparecen caídas nuevas: son versiones nuevas de las de siempre.
Confiabilidad por política
Cada equipo arma su propia herramienta, nadie obliga a usarla y no se actualiza con las lecciones nuevas. El trabajo se multiplica: N sistemas por K políticas.
IncorrectoConfiabilidad por defecto
Convergencia: una sola herramienta obligatoria por práctica. Una lección se corrige una vez y llega a todos los sistemas.
Correcto~10 años
Duró el programa de convergencia en Google.
más de 2×
Mejora en frecuencia, alcance y duración de caídas. Cifra de Google: referencia, no meta.
También: prólogo de Benjamin Treynor Sloss — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Basado en cap. 1, “Introducción: modelar lo que hacemos y por qué”, de Christof Leng, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Capa 6
Plataformas: caminos dorados y shift down
La plataforma es un producto interno que vuelve fácil lo correcto
Camino dorado
Plantilla con opinión, de autoservicio y documentada.
Guardarraíles
Verificadores como linters: primero avisan, luego bloquean.
Excepciones
Se permiten con motivo y fecha de caducidad.
Retroalimentación
Se mide adopción, excepciones, toil y carga de alertas.
Shift down
Backoff, autenticación y registros viven en el framework común, no en cada aplicación.
Riesgo adelantado
La disponibilidad avisa tarde; el riesgo identificado avisa antes. Cada postmortem lo suma.
Efecto por defecto
En Google, proteger de sobrecarga al sistema RPC central mejoró a todos a la vez.
También: cap. 23, «El futuro de SRE» (Matt Zelesko) — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Basado en cap. 18, “Ingeniería de plataformas en SRE”, de Chris Jones y Christof Leng, con David Grizzanti y James Brookbank — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Transversal
SRE para la IA: la calidad también es confiabilidad
Un servicio de IA puede estar «arriba» y aun así contestar mal
Disponibilidad
¿El servicio contesta cuando se le llama?
Capacidad de trabajo
¿Cuántas peticiones o fragmentos de texto procesa por segundo?
Latencia
¿Cuánto tarda en empezar a contestar? (TTFT: hasta el primer fragmento)
Calidad
¿Es buena la respuesta? Es el pilar nuevo frente a un servicio común.
Las evaluaciones hacen de SLI
Como la misma pregunta no siempre produce la misma salida, se prueba al sistema con preguntas de referencia y se puntúan sus respuestas. La puntuación mínima aceptable funciona como SLO.
Agentes: la «tríada letal»
Un agente que junta datos privados, contenido no confiable y comunicación hacia afuera puede filtrar información. Se controla con medidas simples, sin depender de otra IA.
La «tríada letal» (lethal trifecta) viene del cap. 14, «Pruebas» (Aman Shaikh y otros).
Basado en cap. 20, “Cómo SRE apoya a la IA”, de Dan Dennison y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Transversal
IA para SRE: más cambios, más cuidado
La IA ayuda a operar, pero cada paso de autonomía se gana con evidencia
10×
Diez veces más cambios, con todo lo demás igual, traen unas diez veces más incidentes. El libro prevé que el «roll forward» (corregir hacia adelante en vez de volver atrás) se vuelva el método principal; es una predicción, no un hecho (esa idea es del cap. 19, autoría no indicada).
Tres pilares para agentes seguros
- Transparencia: se ve qué hace y por qué.
- Contexto: sabe si hay un incidente en curso.
- Autorización progresiva: más permisos con evidencia.
Cada acción lleva su verificación y su vuelta atrás, como una sola operación.
Autonomía por niveles
L4Completo
No todo sistema debe llegar aquí
L3Alto
Actúa en casos acotados
L2Parcial
Se valida a fondo antes de subir
L1Asistido
La IA apoya; empieza por detección y triage
L0Manual
Una persona hace todo
Cap. 10 (Dan Dennison y otros): conviene empezar por detección, triage y permisos de solo lectura.
Basado en cap. 21, “Cómo la IA apoya a SRE”, de Boris Arnoux y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Transversal
Aplicar SRE con un equipo pequeño
No hace falta un equipo grande: hace falta orden de prioridades
Cinco prácticas baratas para empezar
Pruebas automáticas
unitarias y de integración
Despliegue automático
un pipeline de CI/CD
Alertas accionables
que reflejen mala experiencia
Incidentes ordenados
roles claros y sin culpa
Revisión de diseño
dominios de falla y vuelta atrás
Pila de prioridades del SRE en solitario
P0 · Detener la hemorragia
Frenar la falla repetida. Ej.: guardados que se pierden
P1 · Visibilidad
Un tablero: ¿caído?, ¿lento?, ¿roto?, ¿ahuyenta usuarios?
P2 · Automatizar lo más temido
Despliegue de un clic, con vuelta atrás
P3 · Autoservicio
Que otros equipos publiquen sin esperar al SRE
Cinco prácticas: cap. 2, «El valor de la confiabilidad» (Ben McCormack y otros). «Ej.» es un ejemplo ilustrativo, no del libro.
Basado en cap. 22, “SRE en entornos diversos”, de Ana Oprea y otros — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Evaluación rápida
Seis preguntas, cada una con su respuesta
- 1
Una API devuelve 200, pero pierde datos al guardar. ¿Es confiable?
Respuesta: No. Ser confiable es cumplir su función; un 200 no basta. (cap. 1)
- 2
¿En qué se distinguen un SLI y un SLO?
Respuesta: El SLI es lo que se mide; el SLO es la meta fijada para ese indicador. (cap. 8)
- 3
¿Cuántos errores admite un SLO de 99.9 % con 100,000 solicitudes?
Respuesta: 100: el 0.1 % restante es el presupuesto de error. (cap. 8)
- 4
Una actualización provoca 20 % de errores. ¿Qué haces primero?
Respuesta: Mitigar y recuperar el servicio; entender los factores contribuyentes y el postmortem sin culpa vienen después. (cap. 10)
- 5
¿Qué es la confiabilidad emergente?
Respuesta: Plataformas y prácticas que hacen confiables a los sistemas por defecto. (caps. 1 y 18)
- 6
¿Hay que completar una capa de la jerarquía de salud antes de subir a la siguiente?
Respuesta: No. Las capas se trabajan en paralelo; la cultura es la base que las sostiene. (cap. 1)
Basado en cap. 1, “Introducción: modelar lo que hacemos y por qué”, de Christof Leng, con Carmela Quinito — Site Reliability Engineering, 2.ª ed. (CC BY-NC-ND 4.0)
Anexo · caso propio
Cómo ozeida aplica estas ideas
Esta diapositiva no forma parte del libro: es el proyecto de Bruno Villarreal
Calidad de A a F
Un puntaje claro para quien no es técnico.
Idea del libro: el SLO como lenguaje común
Tableros técnicos
Claros, para investigar la causa de un problema.
Idea del libro: observabilidad
Alarmas
Con su estado actual y sin recortes.
Idea del libro: alertar por síntomas
Asistente con IA
Explica lo que ocurre; no decide por sí solo.
Idea del libro: autonomía por niveles
Construir una alternativa a Grafana es ingeniería de observabilidad.
Usar sus datos para mejorar la confiabilidad es SRE.
ozeida está en fase de diseño: esto describe su propósito, no un producto terminado.
Créditos
Créditos y licencia
Presentación de Bruno Villarreal, basada en un libro con licencia abierta
Site Reliability Engineering, 2.ª edición
Editores: Betsy Beyer, Chris Jones, Christof Leng, David Huska, Jennifer Petoff y Niall Richard Murphy. Prólogo de Benjamin Treynor Sloss. O’Reilly Media, 2026.
CC BY-NC-ND 4.0
Atribución, no comercial, sin obras derivadas, 4.0 Internacional. Ver la licencia
Figura 1-2 del libro
«A modern hierarchy of production health», cap. 1 (Christof Leng, con Carmela Quinito; editores del libro: ver arriba). Copyright © 2026 Google LLC and Niall Murphy. Imagen original, sin modificaciones.
Lecturas complementarias (externas)
The Site Reliability Workbook · documentación de OpenTelemetry · AWS Well-Architected, Reliability Pillar
Este material resume ideas del libro con palabras propias; la Figura 1-2 se reproduce sin modificaciones.
Créditos
Créditos: quién escribió los capítulos
Autores y colaboradores de los capítulos 1 a 23 y del prólogo, por orden alfabético de nombre
Alex Bramley · Alex Chiang · Alex Perry · Aman Shaikh · Amber Hillhouse · Ana Oprea · Andy Gordon · Ayelet Sachto · Ben McCormack · Benjamin Treynor Sloss · Bharath Modhipalli · Boris Arnoux · Brent Bryan · Brett Beekley · Brian Kudzia · Carmela Quinito · Chris Jones · Chris Kirby · Chris Wasik · Christof Leng · Clément Baïsse · Dan Dennison · Daniel Hobe · Daniel Marshall · David Bayer · David Grizzanti · David Hixson · David Huska · Derek Remund · Dice Ephemera · Elliot Williams · Ethan Truong · Faraz Khan · Forrest Seiwald · Frank Szczerba · Garrett Holthaus · Garrett Plasky · Hannes Eder · Ian Schlesinger · Igor Oks · Ioannis Papapanagiotou · Isaac Albarrán Muñoz · James Brookbank · Jennifer Mace · Jennifer Petoff · Jessica McCarthy · Joanna Wijntjes · John Lunney · John Tobin · Joon Lee · Jose Andrade · Josh Suereth · Katie Poskaitis · Kieran Broadfoot · Kyusoon Lee · Leland Jefferis · Luca Cervasio · Mahesh Chellappa · Marcin Brodziak · Matt Zelesko · Max Luebbe · Micah Lerner · Michael Harris · Michelle Brush · Nathen Harvey · Nevin Lazarus · Niall Richard Murphy · Nicholas Crespi · Nick Soda · Oleg Klyudt · Omer Habas · Parker Roth · Pereira Braga · Pim van Pelt · Qin Jia · Ralf Wildenhues · Ramón Medrano Llamas · Raphael Menderico · Rita Lu · Rob Whitaker · Robin Roth · Roman Seibel · Ruben Barroso · Ruslan Meshenberg · Samantha Schaevitz · Saurabh Phaltane · Sierra Ventuleth · Steffen Mueller · Stephanie Yan · Stevan Malesevic · Sue Lueder · Thais Melo · Theo Klein · Thomas C. Hubschman · Thomas Voß · Tim Falzone · Trevor Mattson-Hamilton · Vartika Agarwal · Victoria Wang · Vitaliy Shipitsyn · William Thurston · Yael Evron Sabag · Ying Wang · Yuri Grinshteyn
Cada diapositiva cita al pie su capítulo. El capítulo 19 no indica autoría en el texto.
La idea que debes conservar
SRE es usar ingeniería para que la confiabilidad se pueda definir, medir, mejorar y mantener
Una prueba rápida: ¿se alinea con el negocio?, ¿mejora la confiabilidad?, ¿usa ingeniería? Las herramientas, como Grafana o Kubernetes, vienen después.
SRE de 0 a 100 · Bruno Villarreal
Diapositiva 1 de 59: SRE de 0 a 100